
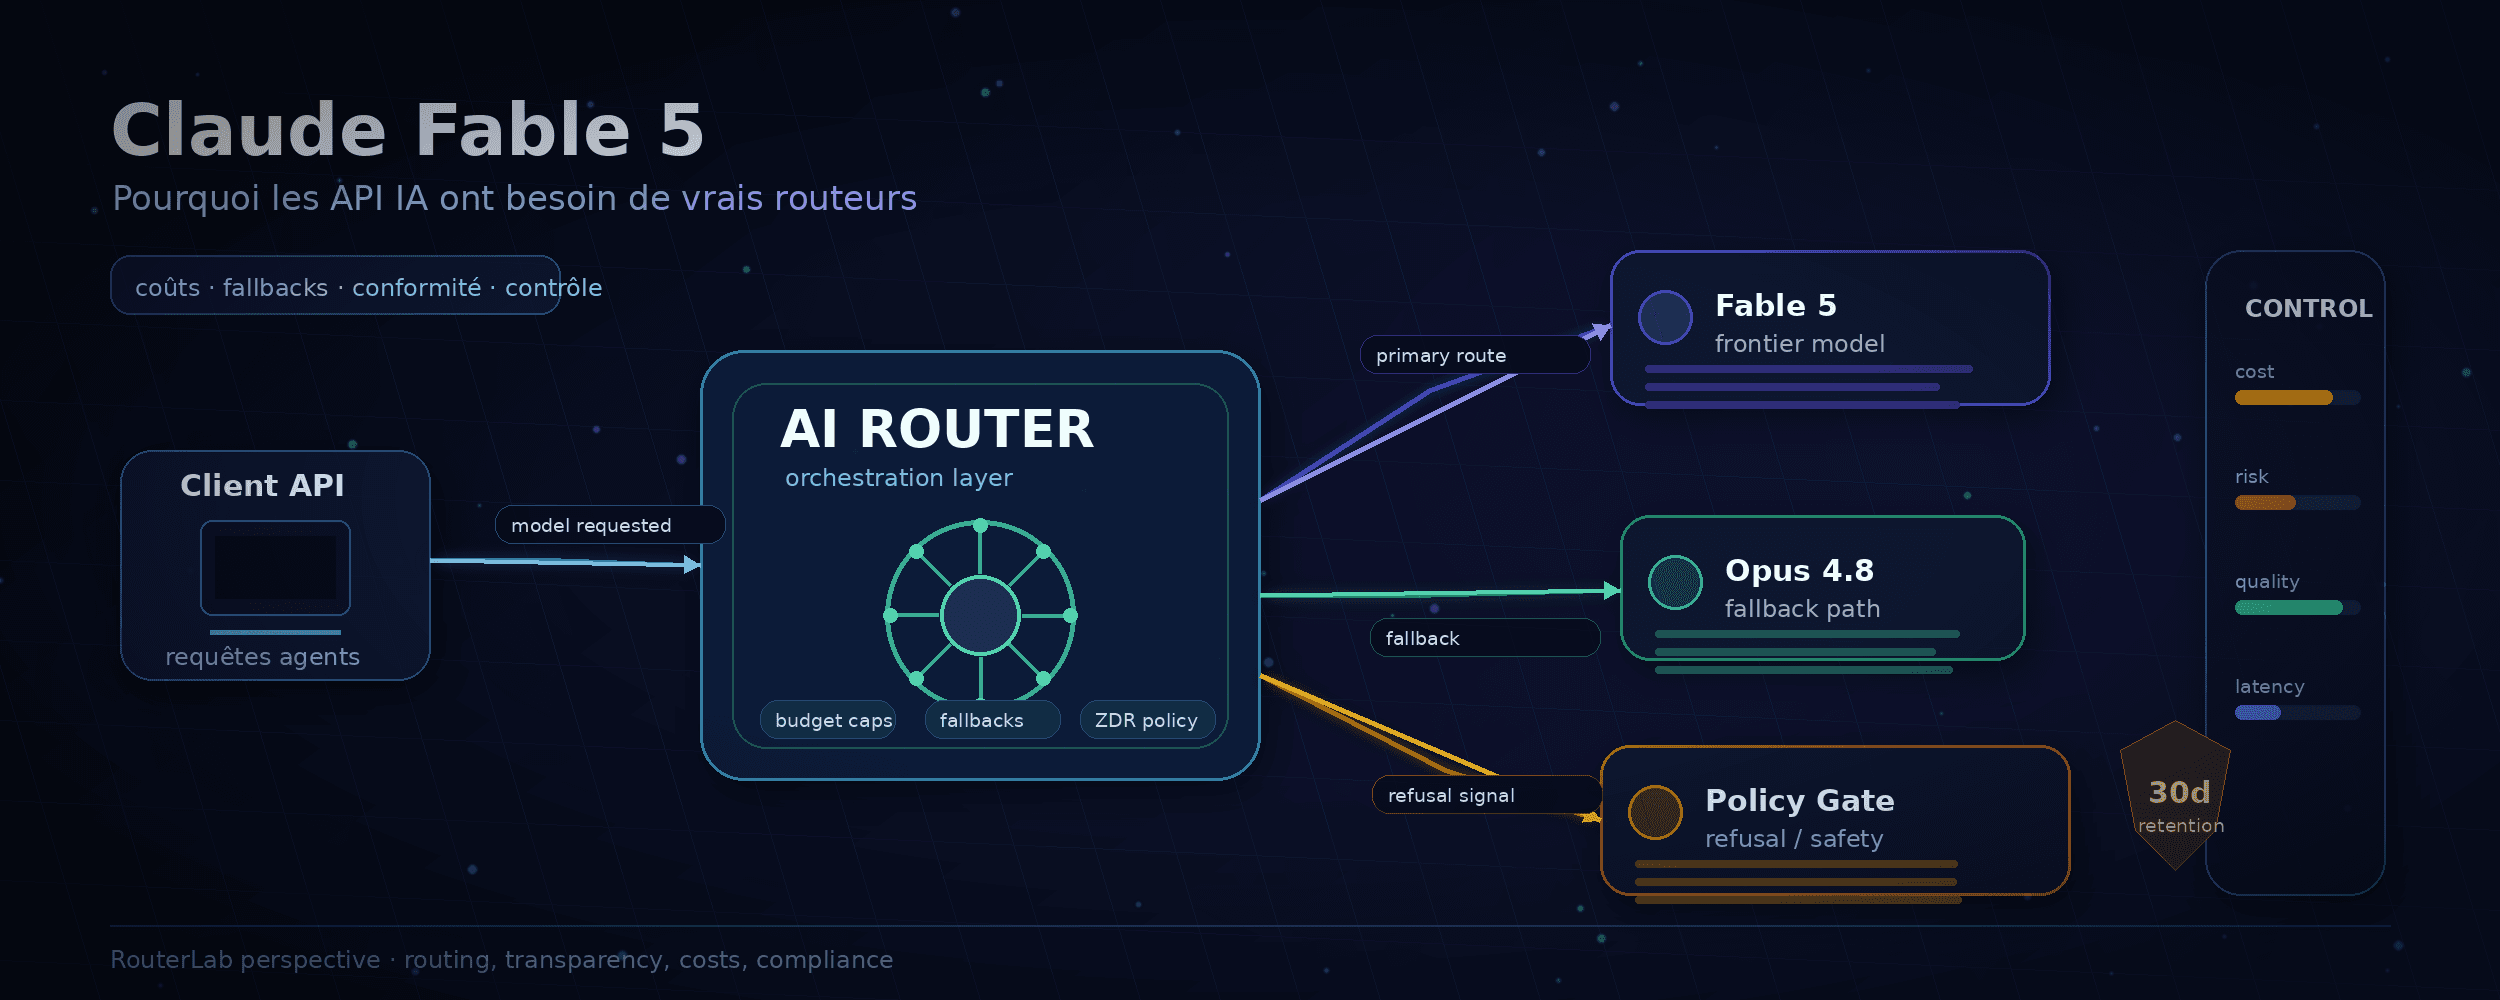
Anthropic hat Claude Fable 5 veröffentlicht, sein erstes Modell der Mythos-Klasse, das der breiten Öffentlichkeit zugänglich ist.
In Benchmarks beeindruckt das Modell. Es übertrifft seine Vorgänger bei Code, autonomen Agenten, langen Aufgaben und komplexem Reasoning.
Doch diese Veröffentlichung zeigt vor allem eine tiefere Entwicklung des Marktes: Die leistungsfähigsten Modelle sind keine einfachen Endpoints mehr, die man direkt aufruft.
Sie kommen mit Sicherheitsregeln, Fallback-Mechanismen, domänenspezifischen Einschränkungen, eigenen Aufbewahrungsrichtlinien und teilweise unterschiedlichen Zugriffsbedingungen je nach Kundenprofil.
Rohe Leistung reicht nicht mehr aus. Das eigentliche Thema ist jetzt Kontrolle.
Fable 5 und Mythos 5: gleiche Basis, unterschiedlicher Zugang
Anthropic bietet zwei Modelle aus derselben Leistungsklasse an.
Claude Fable 5 ist die öffentliche Version. Sie ist über die klassische API verfügbar und verfügt über strenge Sicherheitsleitplanken.
Claude Mythos 5 bleibt einem kleineren Kreis vorbehalten: Cybersicherheitspartnern, geprüften Organisationen und bestimmten vertrauensbasierten Zugangsprogrammen.
Anthropic gibt an, dass beide Modelle auf derselben technischen Grundlage beruhen, Mythos 5 jedoch in bestimmten Bereichen von weniger strengen Schutzmechanismen profitiert.
Der Unterschied betrifft also nicht nur die Leistung.
Es geht um Zugriffsniveau, angewandte Einschränkungen und die tatsächlich erlaubten Anwendungsfälle.
Für einen Endanwender kann das abstrakt bleiben.
Für eine API-Plattform, einen Modellrouter oder ein Agentensystem ist es zentral.
Automatisches Fallback: die eigentliche Veränderung
Fable 5 funktioniert nicht genau wie ein klassischer Endpoint.
Wenn eine Anfrage sensible Bereiche berührt – Cybersicherheit, Biologie, Chemie oder bestimmte Hochrisikothemen –, können Sicherheitsklassifikatoren eingreifen.
Je nach Kanal, Konfiguration oder Fallback-Optionen kann dies zu einer ausdrücklichen Ablehnung oder zu einer Weiterleitung an Claude Opus 4.8 führen.
Das Ziel von Anthropic ist nachvollziehbar: Eine vollständige Blockierung soll vermieden werden, indem eine Antwort über ein als weniger riskant eingestuftes Modell bereitgestellt wird.
Für Integration und Nutzererfahrung entsteht dadurch jedoch ein konkretes Problem.
Die Anwendung oder der Entwickler glaubt, Fable 5 zu verwenden.
Je nach Thema kann die Antwort jedoch von einem anderen Modell stammen – oder die Anwendung erhält eine Ablehnung, die sie korrekt behandeln muss.
Das ist nicht unbedingt problematisch, wenn der Vorgang transparent ist.
Es wird problematisch, wenn Entwickler, Anwendung oder Endkunde nicht klar verstehen, was passiert ist.
Falschpositive Treffer und ein vorsichtiger Start
Anthropic hat eingeräumt, die Sicherheitsleitplanken für eine schnelle öffentliche Veröffentlichung sehr konservativ eingestellt zu haben.
Diese Entscheidung hat einen Preis: falschpositive Treffer.
Bestimmte legitime Anfragen zu Biologie, Immunologie oder wissenschaftlicher Forschung können Weiterleitungen oder Ablehnungen auslösen.
Eine normale wissenschaftliche Frage kann von den Klassifikatoren als sensibel eingestuft werden, obwohl sie keinerlei schädliche Absicht hat.
Nach den ersten Rückmeldungen begann Anthropic, die Transparenz bei Ablehnungen und Weiterleitungen zu verbessern.
Das ist ein positiver Schritt.
Er beseitigt jedoch nicht das Grundproblem: Frontier-Modelle sind keine statischen Systeme mehr.
Ihr Verhalten hängt nun von Klassifikatoren, Sicherheitsrichtlinien, Fallback-Regeln und teilweise vom Zugriffslevel des Kunden ab.
Die Kosten: Leistung gegen Rentabilität
Fable 5 kostet 10 Dollar pro Million Eingabetokens und 50 Dollar pro Million Ausgabetokens.
Das ist doppelt so viel wie bei Opus 4.8.
Bei kritischen und komplexen Aufgaben kann dieser Preis gerechtfertigt sein. Wenn das Modell ein schwieriges Problem löst, Fehler vermeidet oder Arbeitszeit reduziert, können die Kosten akzeptabel bleiben.
Bei autonomen Agenten, Korrektur-Workflows und iterativer Entwicklung sieht die Lage jedoch anders aus.
Ein Agent stellt nicht nur eine Anfrage.
Er liest Dateien, plant, schreibt Code, korrigiert, testet, analysiert Fehler und beginnt erneut.
Bei solchen Preisen kann eine ineffiziente Routing-Strategie einen Produktivitätsgewinn in schwer kontrollierbare Kosten verwandeln.
Die Frage lautet also nicht mehr nur:
Welches ist das beste Modell?
Die eigentliche Frage lautet:
Welches Modell soll für diese konkrete Aufgabe verwendet werden – mit welcher Kontrolle über Kosten, Verhalten und Compliance?
Benchmarks vs. Produktionsrealität
Benchmarks bleiben nützlich.
Sie ermöglichen es, Fortschritte zu messen und Modelle anhand standardisierter Aufgaben zu vergleichen.
Doch sie reichen nicht mehr aus, um ein Modell unter realen Bedingungen zu bewerten.
Ein Modell kann die Ranglisten anführen und in der Produktion dennoch wegen Fallbacks, Ablehnungen oder domänenspezifischer Verhaltensänderungen unvorhersehbar sein.
Umgekehrt kann ein etwas weniger leistungsfähiges, aber stabiles, nachvollziehbares und vorhersehbares Modell operativ interessanter sein.
Für eine API-Plattform zählt nicht nur der rohe Score.
Entscheidend ist das Verhältnis zwischen:
- der tatsächlichen Antwortqualität;
- den Kosten pro abgeschlossener Aufgabe;
- der Fallback-Rate;
- der Ablehnungsrate;
- der Verhaltensstabilität;
- der Transparenz über das tatsächlich verwendete Modell;
- der Aufbewahrungsrichtlinie;
- der Einhaltung der Kundenvorgaben.
Ein sehr leistungsfähiges, aber schwer vorhersehbares Modell kann weniger rentabel sein als ein etwas schwächeres Modell, das besser kontrolliert wird.
Orchestrierung wird unverzichtbar
Bei einer einfachen Nutzung kann ein Fallback auf ein anderes Modell akzeptabel bleiben.
Für eine professionelle API reicht das nicht aus.
Eine Plattform, die mehrere Modelle anbietet, muss genau wissen:
- welches Modell angefordert wurde;
- welches Modell tatsächlich geantwortet hat;
- ob ein Fallback oder eine Ablehnung stattgefunden hat;
- warum dieses Fallback oder diese Ablehnung ausgelöst wurde;
- welche Aufbewahrungsrichtlinie gilt;
- welcher Preis berechnet werden muss;
- welche Nachricht dem Endnutzer angezeigt werden soll.
Ohne diese Kontrollschicht wird die API undurchsichtig.
In einer professionellen Infrastruktur zerstört Undurchsichtigkeit das Vertrauen.
Ein Kunde, der für Fable 5 bezahlt, muss nachvollziehen können, wann er tatsächlich Fable 5 verwendet, wann ein anderes Modell übernimmt und warum.
Er muss außerdem sein Budget kontrollieren und verhindern können, dass autonome Agenten ohne Transparenz Credits verbrauchen.
Datenaufbewahrung und europäische Anforderungen
Anthropic bewahrt den API-Datenverkehr von Fable 5 und den Modellen der Mythos-Klasse 30 Tage lang auf.
Diese Daten werden für die Sicherheit verwendet, nicht zum Training neuer Modelle.
Aus sicherheitstechnischer Sicht ist dieser Ansatz vertretbar: Missbrauchserkennung, Analyse komplexer Angriffe, Nachverfolgung von Jailbreaks und Verbesserung der Sicherheitsleitplanken.
Für europäische Organisationen mit strengen Anforderungen an Datenschutz, Datensouveränität oder Zero Data Retention ist dies jedoch ein sensibler Punkt.
Auch hier ist das technisch leistungsfähigste Modell nicht immer das am besten geeignete.
Das richtige Modell hängt vom Nutzungskontext, Budget, akzeptablen Risikoniveau und den vertraglichen Verpflichtungen ab.
Sicherheit oder Zugriffsegmentierung?
Anthropic begründet diese Einschränkungen mit Sicherheitsanforderungen.
Diese Erklärung ist teilweise stichhaltig.
Ein sehr leistungsfähiges Modell kann bei sensiblen Themen wie offensiver Cybersicherheit, bestimmten biologischen Aufgaben oder Modelldestillation nicht ohne Schutzmechanismen bereitgestellt werden.
Wenn jedoch zwei Versionen derselben technischen Grundlage mit je nach Kundenprofil unterschiedlichen Einschränkungen existieren, zeigt sich auch eine Form der Zugriffsegmentierung.
Einige Nutzer profitieren von weniger Einschränkungen als andere.
Dieses Phänomen ist nicht neu, wird mit Frontier-Modellen aber deutlich sichtbarer.
Es verstärkt die Notwendigkeit für Plattformen, die tatsächlichen Nutzungsbedingungen ihrer angebotenen Modelle zu verstehen.
Was API-Plattformen umsetzen müssen
Die fortschrittlichsten Modelle kommen immer häufiger mit variablen Nutzungsbedingungen.
Für API-Plattformen bedeutet das, eine echte Orchestrierungsschicht aufzubauen, die Folgendes kann:
- je nach Aufgabentyp intelligent routen;
- Fallbacks explizit verwalten;
- das tatsächlich verwendete Modell protokollieren;
- Ablehnungen erkennen und erklären;
- die richtigen Aufbewahrungsrichtlinien anwenden;
- Kosten pro Aufgabe kontrollieren;
- unnötige Retry-Schleifen vermeiden;
- Endnutzern Transparenz bieten.
Genau das ist die Rolle eines modernen KI-Routers.
Ein Router darf eine Anfrage nicht einfach nur an das leistungsfähigste Modell senden.
Er muss das richtige Modell zum richtigen Zeitpunkt, zum richtigen Preis und mit dem passenden Maß an Transparenz auswählen.
Fazit
Claude Fable 5 ist ein beeindruckendes Modell.
Seine Veröffentlichung zeigt jedoch vor allem die nächste Phase des KI-Marktes: leistungsfähigere, teurere, stärker gefilterte und schwieriger sauber zu integrierende Modelle.
Die Frage lautet nicht mehr nur, ob Fable 5 besser ist als Opus 4.8, ein aktuelles GPT-Modell oder Gemini 3.1 Pro.
Die eigentliche Frage ist, wie eine Infrastruktur aufgebaut werden kann, die diese Modelle nutzt, ohne die Kontrolle über Kosten, Compliance und Nutzererfahrung zu verlieren.
Für Endnutzer ist Fable 5 ein neues Modell.
Für Entwickler und API-Plattformen ist es ein klares Signal.
Die Zeit, in der man einfach ein Modell aus einer Liste auswählte, geht zu Ende.
Die Zukunft gehört Plattformen, die intelligent routen, Verhalten nachvollziehbar machen und dem Kunden garantieren können, was er tatsächlich nutzt.
Mit Fable 5 zeigt Anthropic nicht nur ein leistungsfähigeres Modell.
Es zeigt, dass rohe Leistung nicht mehr ausreicht.
Das eigentliche Produkt ist jetzt Kontrolle.
Testen Sie die RouterLab-API
Gehen Sie von einem Artikel zu einer tatsächlichen Abfrage über: Erstellen Sie eine Testversion, rufen Sie einen Schlüssel ab und rufen Sie Modelle über eine OpenAI-kompatible API auf.