
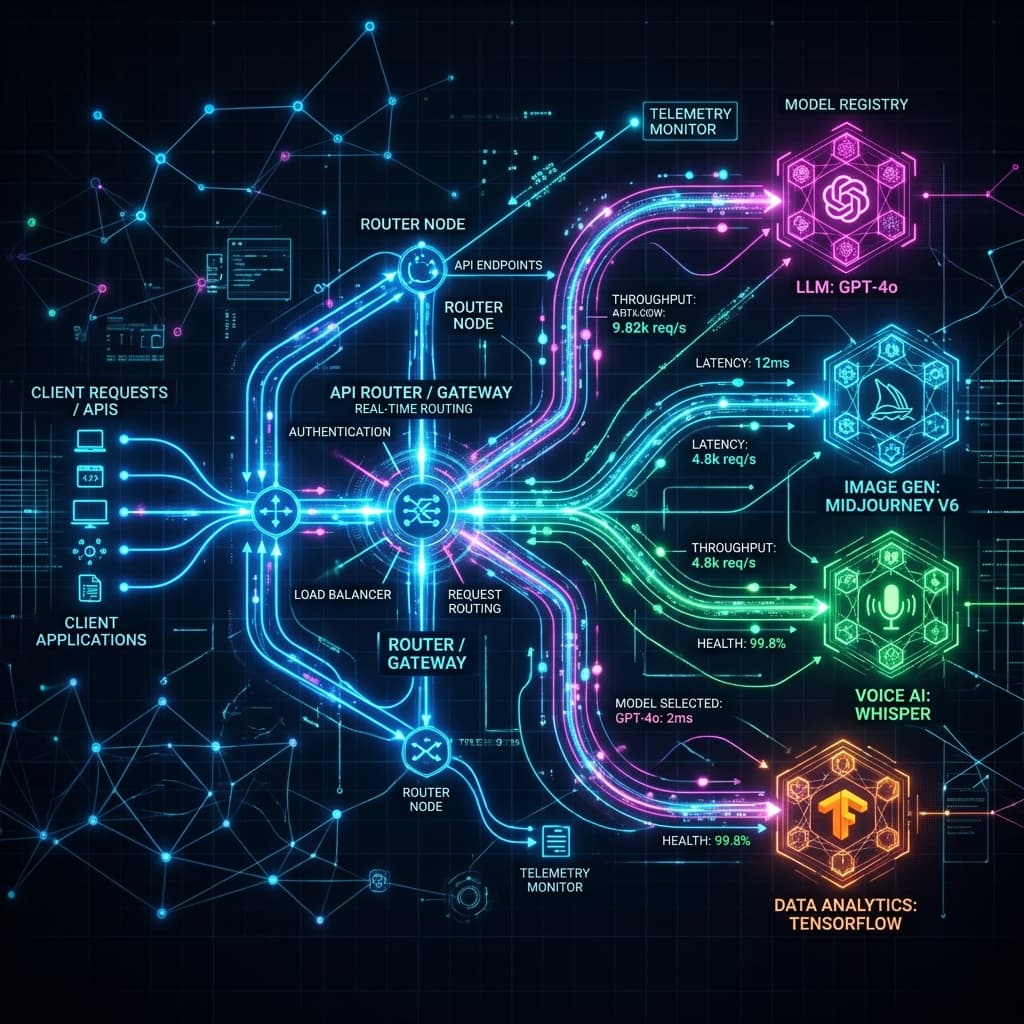
Heute ist es trivial, einen API-Aufruf an ein LLM zum Laufen zu bringen. Jeder Entwickler kann mit drei Codezeilen Text erzeugen. Wenn jedoch täglich Millionen von Anfragen durch Multi-Modell-Architekturen orchestriert werden sollen, sieht die Realität anders aus: Ihr Code funktioniert – aber ist er wirklich robust?
Im Jahr 2026 geht es nicht mehr nur darum, eine Antwort von der KI zu erhalten. Es geht darum, die Latenz zu beherrschen, intelligent zu routen, um Inferenzkosten zu senken, und eine hohe Verfügbarkeit sicherzustellen. In diesem Umfeld kann ein einfacher KeyError in einem unerwarteten JSON-Payload, der von einem Open-Source-Modell stammt, einen gesamten kritischen Verarbeitungslauf zum Absturz bringen.
Der Infrastrukturcode rund um Ihre LLMs muss paranoid sein. Er muss seine Absicht klar ausdrücken, die mentale Belastung während Bereitschaftseinsätzen reduzieren und Ausfälle vorwegnehmen. So verwandeln Sie drei Standardfunktionen von Python in echte Schutzschilde für Ihre KI-Gateways.
💡 TL;DR
- Tuple Unpacking: Einen strengen Vertrag erzwingen, damit bei jedem Aufruf Telemetrie (Tokens, Latenz) erfasst wird.
- List Comprehensions: Einen funktionalen Ansatz für die Filterung von Batches verwenden, um veränderlichen Zustand und Overhead zu reduzieren.
- Defensives Parsing (
dict.get): Ihre Pipelines gegen „strukturelle Halluzinationen“ und stille API-Änderungen schützen.
1. Tuple Unpacking als strenger Observability-Vertrag
Wenn Sie eine Anfrage an ein LLM routen, ist der zurückgegebene Text nur ein Teil der Gleichung. Um Ihre Kosten zu optimieren, ist die Telemetrie (Antwortzeit, verbrauchte Tokens, verwendetes Fallback-Modell) ebenso entscheidend.
Der naive Ansatz sammelt Zustandsvariablen oder extrahiert die Daten nachträglich. Der Infrastrukturansatz verwendet Tuple Unpacking nicht als syntaktische Abkürzung, sondern als unveränderlichen Vertrag.
Statt des fehleranfälligen Ansatzes:
result = router.dispatch(user_prompt)
content = result[0]
# Risiko: Usage oder Modell nicht zu protokollieren
Der robuste Ansatz (Tuple Unpacking):
content, usage, latency, model_id = router.dispatch(user_prompt)
# Der Vertrag ist explizit: Fehlt eine Metrik, schlägt das Programm sofort fehl (Fail Fast).
# Observability ist bereits beim Entwurf der Methode garantiert.
2. List Comprehensions für zustandslose Batch-Filterung
Bei der Verarbeitung von Anfragen in einem Batch erzeugt die Verwendung klassischer for-Schleifen mit .append() einen veränderlichen Zustand (die wachsende Liste). Das bringt Speicherrisiken mit sich und macht den Code weniger vorhersehbar, wenn ein Thread abstürzt.
Statt des fehleranfälligen Ansatzes:
valid_responses = []
for resp in batch_results:
    if is_valid(resp):
        valid_responses.append(resp)
Der robuste Ansatz (List Comprehension):
valid_responses = [resp for resp in batch_results if is_valid(resp)]
Das ist schneller (Optimierung auf C-Ebene in CPython), vollständig ohne veränderlichen Zustand und stellt sicher, dass keine externe Logik Ihre gerade erstellte Liste verändert.
3. Defensives Parsing (dict.get) gegen „strukturelle Halluzinationen"
LLMs können gelegentlich Schlüssel auslassen oder komplexe Strukturen verändern, selbst wenn sie so konfiguriert sind, dass sie striktes JSON zurückgeben – insbesondere kleinere Fallback-Modelle. Ein einfaches response["choices"][0]["message"]["content"] ist eine Zeitbombe.
Statt des fehleranfälligen Ansatzes:
# Ein KeyError lässt die gesamte Pipeline abstürzen, wenn das Modell 'message' auslässt
extracted_text = payload["choices"][0]["message"]["content"]
Der robuste Ansatz (Chaining mit .get()):
# Schützt die Extraktion vor unvollständigen Strukturen
choices = payload.get("choices", [])
first_choice = choices[0] if choices else {}
message = first_choice.get("message", {})
extracted_text = message.get("content", "Generierungsfehler")
Der Code wird robust. Eine Halluzination in der JSON-Struktur bringt die Anwendung nicht mehr zum Absturz, sondern wird elegant mit sicheren Standardwerten behandelt.
Fazit
Der Erfolg einer produktiven KI-Infrastruktur hängt nicht vom cleversten Prompt ab. Er hängt davon ab, ob Sie zuverlässige Schutzmauern um einen grundsätzlich probabilistischen Prozess bauen können. Python stellt die Werkzeuge bereit – wir müssen sie nur entsprechend einsetzen.
Testen Sie die RouterLab-API
Gehen Sie von einem Artikel zu einer tatsächlichen Abfrage über: Erstellen Sie eine Testversion, rufen Sie einen Schlüssel ab und rufen Sie Modelle über eine OpenAI-kompatible API auf.