
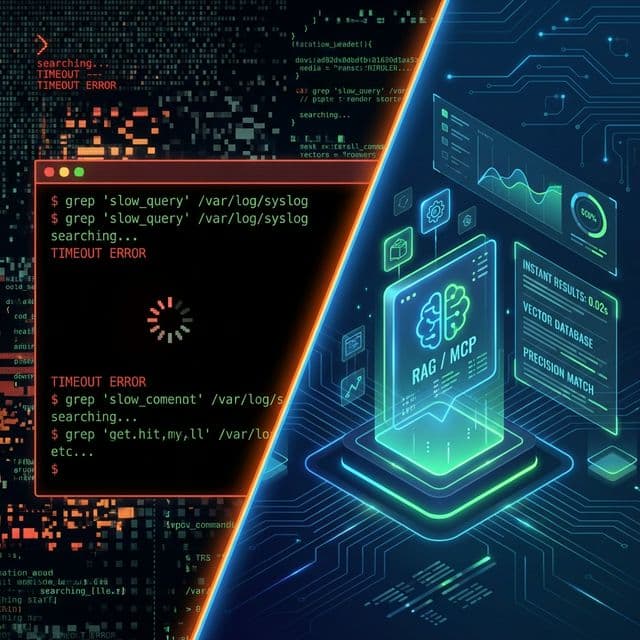
L'utilisation d'agents IA dans le terminal, comme Claude Code, est une révélation pour beaucoup de développeurs. Mais cette magie se heurte rapidement à une limite physique : la gestion du contexte.
Sur une petite base de code, tout est fluide. Mais dès que votre projet dépasse quelques dizaines de fichiers, les performances s'effondrent.
Pourquoi ? Parce que par défaut, Claude fonctionne comme une base de données sans index.
Cet article explore comment implémenter une architecture RAG (Retrieval-Augmented Generation) locale pour transformer votre assistant CLI en un outil chirurgical, réduisant la latence et la consommation de tokens de plus de 90%.
Le goulot d'étranglement : "Full Table Scan" vs Index
Lorsque vous demandez à Claude : "Comment est gérée l'authentification ?", l'agent n'a pas de connaissance préexistante de votre code. Il doit la découvrir.
Par défaut, sa stratégie est brutale :
- Il liste tous les fichiers (
ls -R/ glob). - Il cherche des occurrences textuelles (
grep). - Il lit des fichiers entiers pour valider leur pertinence.
En termes de bases de données, c'est un Full Table Scan. C'est inefficace, lent et coûteux. Pour une simple question, l'agent peut lire 3000 tokens de code inutile juste pour trouver les 50 tokens pertinents.
La solution : L'indexation locale via MCP
La solution consiste à pré-calculer la connaissance du projet. Au lieu de laisser l'IA fouiller les fichiers à chaque requête, nous allons utiliser qmd, un outil open-source qui agit comme un serveur MCP (Model Context Protocol).
qmd génère deux types d'index sur votre machine :
- Lexical (BM25) : Pour les recherches de mots-clés exacts.
- Sémantique (Embeddings) : Pour comprendre les concepts ("gestion des erreurs" trouvera du code même si le mot "erreur" n'est pas présent).
Le changement de paradigme est radical : l'agent interroge l'index, reçoit un extrait classé par pertinence, et répond.
Implémentation technique
Voici comment mettre en place cette architecture sur votre environnement de développement.
1. Installation de la stack
Nous utilisons bun comme runtime pour sa rapidité, et qmd comme moteur d'indexation.
# Installation du moteur
curl -fsSL https://bun.sh/install | bash
bun install -g https://github.com/tobi/qmd
2. Création des vecteurs
Dans la racine de votre projet, initialisez la collection. C'est ici que qmd va "lire" votre code pour la première fois et créer sa carte mentale.
# Création de la collection et filtrage des fichiers pertinents
qmd collection add . --name backend-api --mask "**/*.{ts,tsx,go,rs,md}"

# Génération des embeddings (étape cruciale pour la recherche sémantique)
qmd embed
Note : Contrairement à un grep qui est instantané mais bête, cette étape prend quelques secondes au début, mais rendra toutes les futures requêtes instantanées.
3. Le pont MCP
Claude Code doit savoir que ce serveur existe. Modifiez votre configuration ~/.claude/mcp.json :
{
  "mcpServers": {
    "qmd": {
      "command": "qmd",
      "args": ["mcp"]
    }
  }
}
4. Prompt Engineering (Le fichier CLAUDE.md)
C'est l'étape déterminante. Sans instruction, Claude continuera d'utiliser ses outils natifs par habitude. Nous devons forcer l'utilisation de l'index via une règle système dans le fichier CLAUDE.md à la racine du projet.
## Règle Système : Priorité à l'Indexation

**Directive Critique :** Ne scannez jamais le système de fichiers (ls/grep/read) pour la découverte d'information.

1. Utilisez EXCLUSIVEMENT l'outil `qmd` pour toute recherche de contexte.
2. Utilisez `qmd search` pour les identifiants précis (noms de fonctions, constantes).
3. Utilisez `qmd vsearch` pour les concepts abstraits ou l'exploration fonctionnelle.
4. Ne lisez le fichier complet (`Read`) que si l'extrait fourni par `qmd` est insuffisant.
Analyse d'impact : Avant/Après
Sur un projet TypeScript de taille moyenne (200 fichiers), les métriques sont sans appel :
| Métrique | Approche Standard (Grep/Read) | Approche RAG (qmd) | Gain |
|---|---|---|---|
| Tokens consommés (Moyenne/Prompt) | ~3,500 | ~300 | x11 |
| Temps de réponse | 15-20 secondes | 3-5 secondes | x4 |
| Précision du contexte | Faible (beaucoup de bruit) | Élevée (snippets ciblés) | N/A |
Conclusion
L'optimisation des tokens n'est pas qu'une question d'économie financière. C'est une question de flux de travail.
En passant au RAG local, vous supprimez la friction entre votre pensée et la réponse de l'IA. Claude cesse d'être un stagiaire qui fouille dans les archives pour devenir un ingénieur senior qui connaît l'emplacement exact de chaque fonction.
Tester l’API RouterLab
Passez d’un article à une requête réelle : créez un essai, récupérez une clé et appelez les modèles depuis une API compatible OpenAI.