
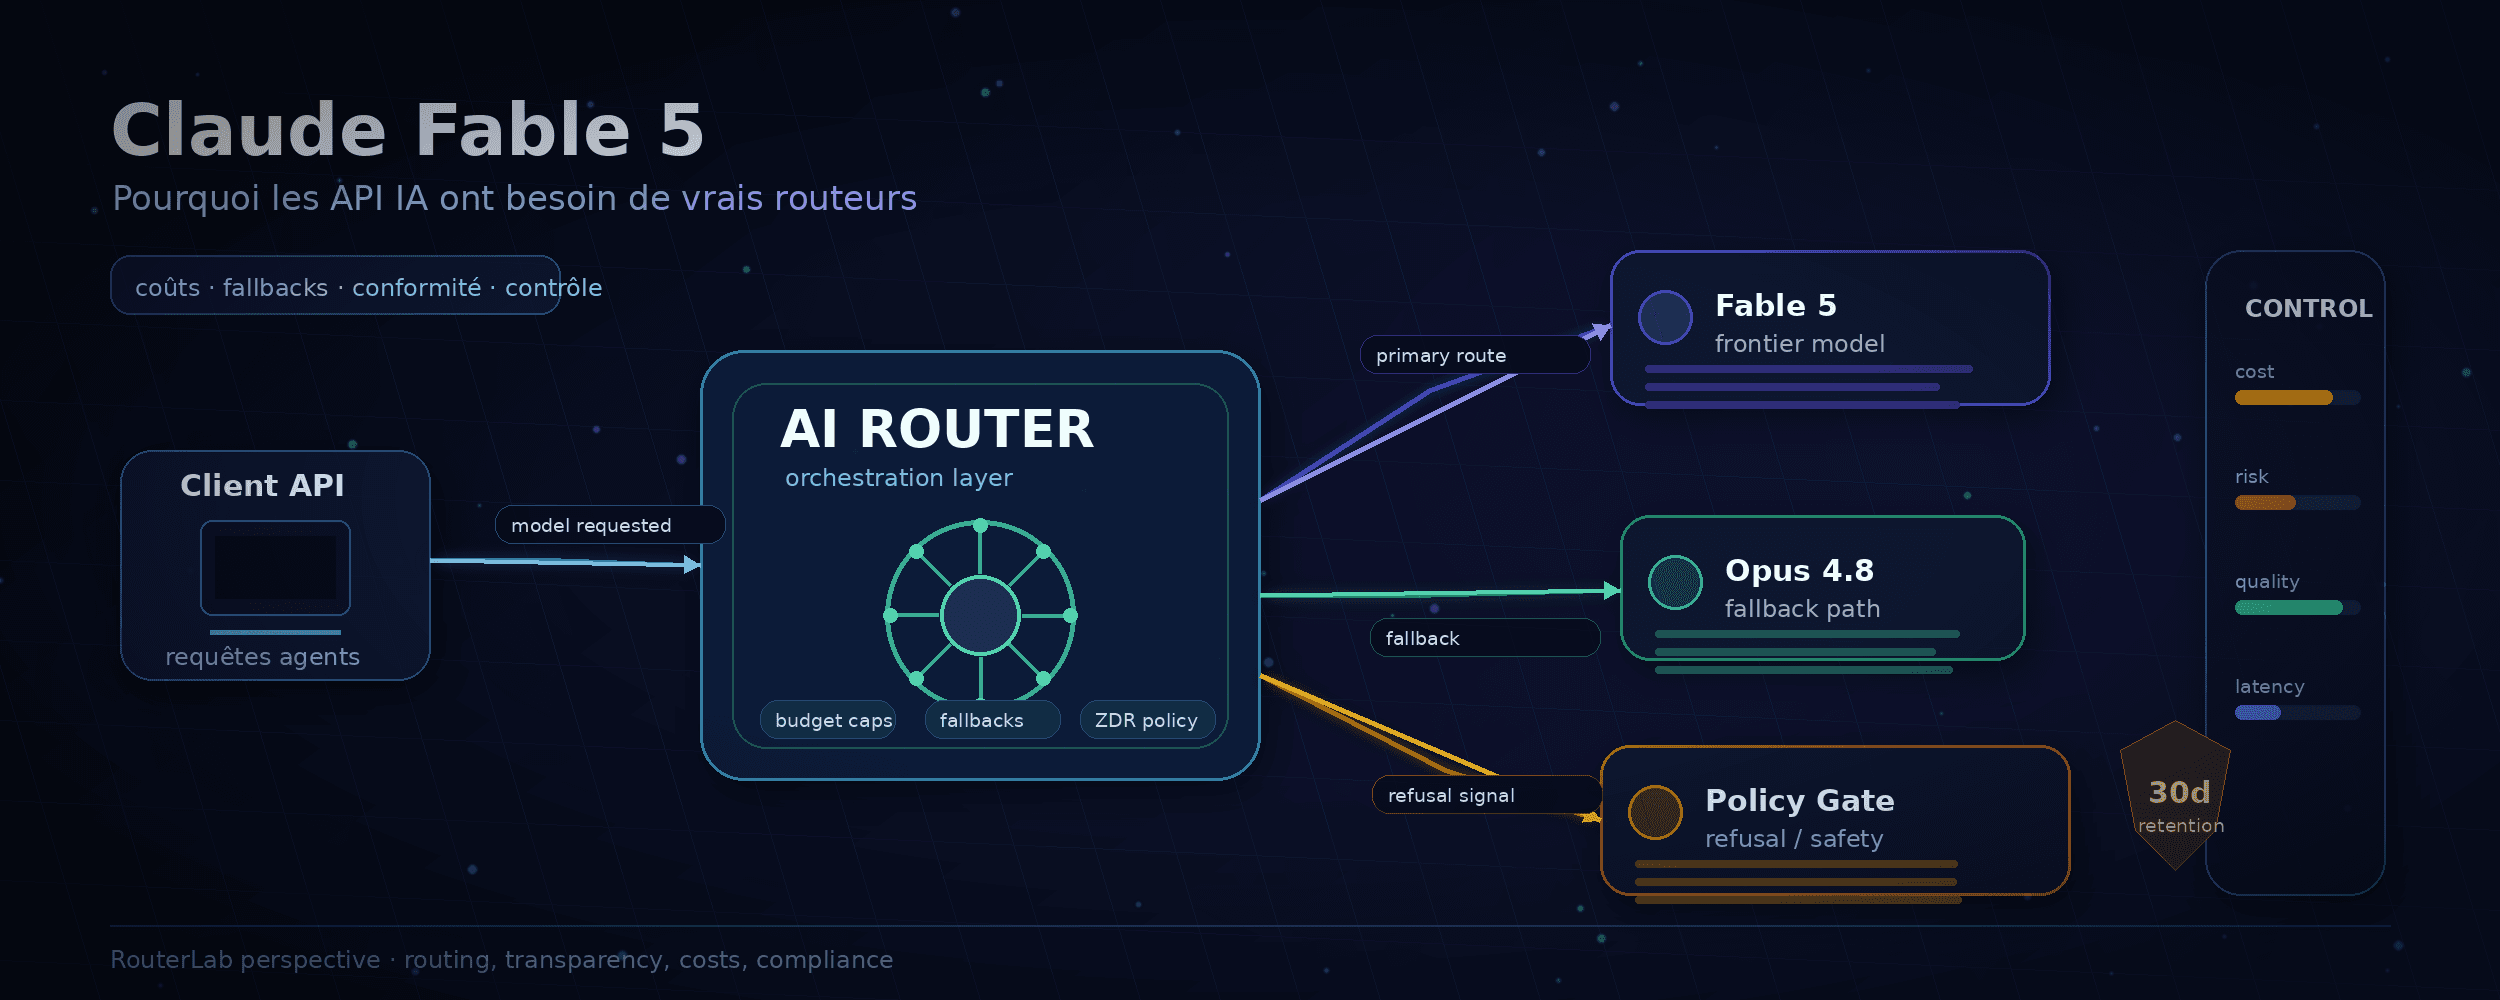
Anthropic a lancé Claude Fable 5, son premier modèle de classe Mythos accessible au grand public.
Sur les benchmarks, le modèle impressionne. Il domine ses prédécesseurs sur le code, les agents autonomes, les tâches longues et le raisonnement complexe.
Mais ce lancement révèle surtout une évolution plus profonde du marché : les modèles les plus puissants ne sont plus de simples endpoints que l’on appelle directement.
Ils arrivent avec des règles de sécurité, des mécanismes de fallback, des restrictions par domaine, des politiques de rétention spécifiques et parfois des différences d’accès selon le profil du client.
La puissance brute ne suffit plus. Le vrai sujet devient le contrôle.
Fable 5 et Mythos 5 : même base, accès différent
Anthropic propose deux modèles issus de la même classe de performance.
Claude Fable 5 est la version publique. Elle est disponible via l’API classique et intègre des garde-fous de sécurité stricts.
Claude Mythos 5 reste réservé à un cercle plus restreint : partenaires de cybersécurité, organisations validées et certains programmes d’accès de confiance.
Anthropic indique que les deux modèles reposent sur le même socle technique, mais que Mythos 5 bénéficie de protections allégées dans certains domaines.
La différence ne porte donc pas seulement sur la performance.
Elle porte sur le niveau d’accès, les restrictions appliquées et les usages réellement autorisés.
Pour un utilisateur final, cela peut rester abstrait.
Pour une plateforme API, un routeur de modèles ou un système d’agents, c’est un élément central.
Le fallback automatique : le vrai changement
Fable 5 ne fonctionne pas exactement comme un endpoint classique.
Lorsqu’une requête touche des domaines jugés sensibles — cybersécurité, biologie, chimie ou certains sujets à haut risque — les classificateurs de sécurité peuvent intervenir.
Selon le canal, la configuration ou les options de fallback, cela peut conduire à un refus explicite ou à une redirection vers Claude Opus 4.8.
L’objectif d’Anthropic est compréhensible : éviter un blocage total en fournissant une réponse via un modèle considéré comme moins risqué.
Mais pour l’intégration et l’expérience utilisateur, ce mécanisme pose un problème concret.
L’application ou le développeur pense utiliser Fable 5.
Pourtant, selon le sujet, il peut recevoir une réponse produite par un autre modèle, ou obtenir un refus qu’il doit gérer correctement côté application.
Ce n’est pas forcément un problème si c’est transparent.
Cela devient un problème si le développeur, l’application ou le client final ne comprend pas clairement ce qui s’est passé.
Faux positifs et lancement conservateur
Anthropic a reconnu avoir réglé les garde-fous de manière très conservatrice afin de permettre une sortie publique rapide.
Ce choix a un coût : des faux positifs.
Certaines requêtes légitimes portant sur la biologie, l’immunologie ou la recherche scientifique peuvent déclencher des redirections ou des refus.
Une question scientifique normale peut être interprétée comme sensible par les classificateurs, même lorsqu’elle n’a aucun caractère offensif.
Après les premiers retours, Anthropic a commencé à améliorer la transparence des refus et des redirections.
C’est une avancée positive.
Mais elle ne supprime pas le problème de fond : les modèles frontier ne sont plus des systèmes statiques.
Leur comportement dépend désormais de classificateurs, de politiques de sécurité, de règles de fallback et parfois du niveau d’accès du client.
Le coût : puissance contre rentabilité
Fable 5 est facturé à 10 dollars par million de tokens en entrée et 50 dollars par million de tokens en sortie.
C’est le double d’Opus 4.8.
Sur des tâches critiques et complexes, ce prix peut se justifier. Si le modèle permet de résoudre un problème difficile, d’éviter des erreurs ou de réduire le temps de travail, le coût peut rester acceptable.
Mais pour les agents autonomes, les workflows de correction et le développement itératif, la situation est différente.
Un agent ne fait pas une seule requête.
Il lit des fichiers, planifie, écrit du code, corrige, teste, analyse les erreurs, recommence.
À ce tarif, une stratégie de routage inefficace peut transformer un gain de productivité en coût difficile à maîtriser.
La question n’est donc plus seulement :
Quel est le meilleur modèle ?
La vraie question devient :
Quel modèle utiliser pour cette tâche précise, avec quel niveau de contrôle sur le coût, le comportement et la conformité ?
Benchmarks vs réalité de production
Les benchmarks restent utiles.
Ils permettent de mesurer les progrès et de comparer les modèles sur des tâches standardisées.
Mais ils ne suffisent plus à évaluer un modèle en conditions réelles.
Un modèle peut dominer les classements tout en étant imprévisible en production à cause des fallbacks, des refus ou des changements de comportement selon le domaine.
À l’inverse, un modèle légèrement moins performant mais stable, traçable et prévisible peut s’avérer plus intéressant opérationnellement.
Pour une plateforme API, ce qui compte vraiment n’est pas seulement le score brut.
Ce qui compte, c’est le rapport entre :
- la qualité réelle de la réponse ;
- le coût par tâche terminée ;
- le taux de fallback ;
- le taux de refus ;
- la stabilité du comportement ;
- la transparence du modèle réellement utilisé ;
- la politique de rétention ;
- la conformité aux contraintes client.
Un modèle très puissant mais difficile à prévoir peut devenir moins rentable qu’un modèle légèrement moins performant, mais mieux maîtrisé.
L’orchestration devient indispensable
Pour un usage simple, un fallback vers un autre modèle peut rester acceptable.
Pour une API professionnelle, c’est insuffisant.
Une plateforme qui expose plusieurs modèles doit être capable de savoir précisément :
- quel modèle a été demandé ;
- quel modèle a réellement répondu ;
- si un fallback ou un refus est intervenu ;
- pourquoi ce fallback ou ce refus a eu lieu ;
- quelle politique de rétention s’applique ;
- quel tarif doit être facturé ;
- quel message doit être affiché à l’utilisateur final.
Sans cette couche de contrôle, l’API devient opaque.
Et dans une infrastructure professionnelle, l’opacité casse la confiance.
Un client qui paye pour Fable 5 doit pouvoir comprendre quand il utilise réellement Fable 5, quand un autre modèle prend le relais, et pourquoi.
Il doit aussi pouvoir maîtriser son budget et éviter que des agents autonomes consomment des crédits sans visibilité.
Rétention des données et contraintes européennes
Anthropic applique une rétention de 30 jours sur le trafic API de Fable 5 et des modèles de classe Mythos.
Ces données sont utilisées pour la sécurité et non pour l’entraînement de nouveaux modèles.
Sur le plan sécuritaire, cette approche peut se défendre : détection d’abus, analyse des attaques complexes, suivi des jailbreaks, amélioration des garde-fous.
Mais pour les organisations européennes soumises à des exigences strictes de confidentialité, de souveraineté des données ou de Zero Data Retention, c’est un point sensible.
Là encore, le modèle techniquement le plus puissant n’est pas toujours le plus adapté.
Le bon modèle dépend du contexte d’utilisation, du budget, du niveau de risque acceptable et des obligations contractuelles.
Sécurité ou segmentation d’accès ?
Anthropic justifie ces restrictions par des impératifs de sécurité.
Cette explication est en partie valide.
Un modèle très capable ne peut pas être mis à disposition sans garde-fous sur des sujets sensibles comme la cybersécurité offensive, certaines tâches biologiques ou la distillation de modèles.
Mais lorsque deux versions du même socle technique coexistent avec des niveaux de restriction différents selon le profil du client, on observe aussi une forme de segmentation d’accès.
Certains utilisateurs bénéficient de moins de limitations que d’autres.
Ce phénomène n’est pas nouveau, mais il devient beaucoup plus visible avec les modèles frontier.
Il renforce la nécessité pour les plateformes de comprendre les conditions réelles d’utilisation des modèles qu’elles proposent.
Ce que les plateformes API doivent mettre en place
Les modèles les plus avancés arrivent de plus en plus avec des conditions d’utilisation variables.
Pour les plateformes API, cela impose de construire une vraie couche d’orchestration capable de :
- router intelligemment selon le type de tâche ;
- gérer les fallbacks de manière explicite ;
- tracer le modèle réellement utilisé ;
- détecter et expliquer les refus ;
- appliquer les bonnes politiques de rétention ;
- contrôler les coûts par tâche ;
- éviter les boucles de retry inutiles ;
- offrir de la transparence aux utilisateurs finaux.
C’est exactement le rôle d’un routeur IA moderne.
Un routeur ne doit pas seulement envoyer une requête au modèle le plus puissant.
Il doit choisir le bon modèle, au bon moment, au bon prix, avec le bon niveau de transparence.
Conclusion
Claude Fable 5 est un modèle impressionnant.
Mais son lancement illustre surtout la prochaine phase du marché IA : des modèles plus puissants, plus chers, plus filtrés et plus complexes à intégrer proprement.
La question n’est plus seulement de savoir si Fable 5 est meilleur qu’Opus 4.8, un modèle GPT actuel ou Gemini 3.1 Pro.
La vraie question est de savoir comment construire une infrastructure capable d’utiliser ces modèles sans perdre le contrôle des coûts, de la conformité et de l’expérience utilisateur.
Pour les utilisateurs finaux, Fable 5 est un nouveau modèle.
Pour les développeurs et les plateformes API, c’est un signal clair.
L’époque où l’on choisissait simplement un modèle dans une liste est en train de disparaître.
L’avenir appartient aux plateformes capables de router intelligemment, de tracer les comportements et de garantir au client ce qu’il utilise réellement.
Avec Fable 5, Anthropic ne montre pas seulement un modèle plus puissant.
Il montre que la puissance brute ne suffit plus.
Le vrai produit, désormais, c’est le contrôle.
Tester l’API RouterLab
Passez d’un article à une requête réelle : créez un essai, récupérez une clé et appelez les modèles depuis une API compatible OpenAI.